
Vous avez entendu parler de RAG, CAG, KAG, ontologie ? Si vous souhaitez comprendre les différences entre ces notions et ce qu’elles recouvrent, vous êtes au bon endroit, on vous explique tout en 5 minutes !
Commençons par le problème que ces quatre notions cherchent à résoudre. Sans lui, elles restent abstraites.
Le point de départ
Un LLM (Claude, ChatGPT, Mistral…) a appris sur une énorme masse de textes, jusqu’à une certaine date. Ce savoir est figé et général. Il ne contient rien de vos documents : procédures, contrats, comptes rendus. Si vous l’interrogez sur ces sujets, soit il dit qu’il ne sait pas, soit il invente une réponse plausible, ce qui est pire.
Il existe deux grandes façons de corriger ça :
- réentraîner le modèle sur vos données (le fine-tuning). C’est lourd, coûteux, et à refaire à chaque mise à jour ;
- lui fournir la bonne information au moment où il répond, sans toucher au modèle.
RAG, CAG et KAG appartiennent à la seconde famille. Ce sont trois manières différentes d’alimenter le modèle au moment de la question. L’ontologie n’est pas une méthode de ce type : c’est une façon d’organiser le savoir, et elle peut servir aux trois.
Une image servira de fil rouge : vous faites appel à un expert brillant qui ne connaît pas votre entreprise, et vous devez lui donner de quoi répondre.
Télécharger la fiche de synthèse gratuite en PDF de: RAG, CAG, KAG, ontologie ? Quelles différences ?
RAG : le documentaliste qui va chercher les bonnes pages
Retrieval-Augmented Generation, ou génération augmentée par la recherche
L’expert ne lit pas tout. À chaque question, un documentaliste fouille les archives, sort les quelques pages les plus pertinentes et les pose devant lui. L’expert répond à partir de ces pages.
Techniquement, ça se passe en deux temps :
- Préparation, une seule fois. Les documents sont découpés en petits morceaux (des chunks). Chaque morceau est converti en une suite de nombres qui représente son sens (un embedding). Le tout est rangé dans une base de données spécialisée, dite vectorielle.
- À chaque question. La question est convertie de la même façon. Le système retrouve les morceaux dont le sens est le plus proche et les ajoute à la consigne envoyée au LLM, qui rédige sa réponse.
Points forts : le RAG fonctionne sur des volumes énormes. Il se met à jour facilement : un document ajouté est simplement indexé. Et il permet de citer les sources utilisées.
Points faibles : tout repose sur la qualité de la recherche. Si le documentaliste rate la bonne page, l’expert répond à côté, avec aplomb. Le découpage en morceaux casse aussi les liens entre les informations. Le RAG classique peine donc sur deux types de questions : celles qui exigent de relier des faits dispersés dans plusieurs documents, et les synthèses globales du type « quels problèmes reviennent dans tous nos comptes rendus ? ».
CAG : l’expert qui a tout lu avant le rendez-vous
Cache-Augmented Generation, ou génération augmentée par le cache
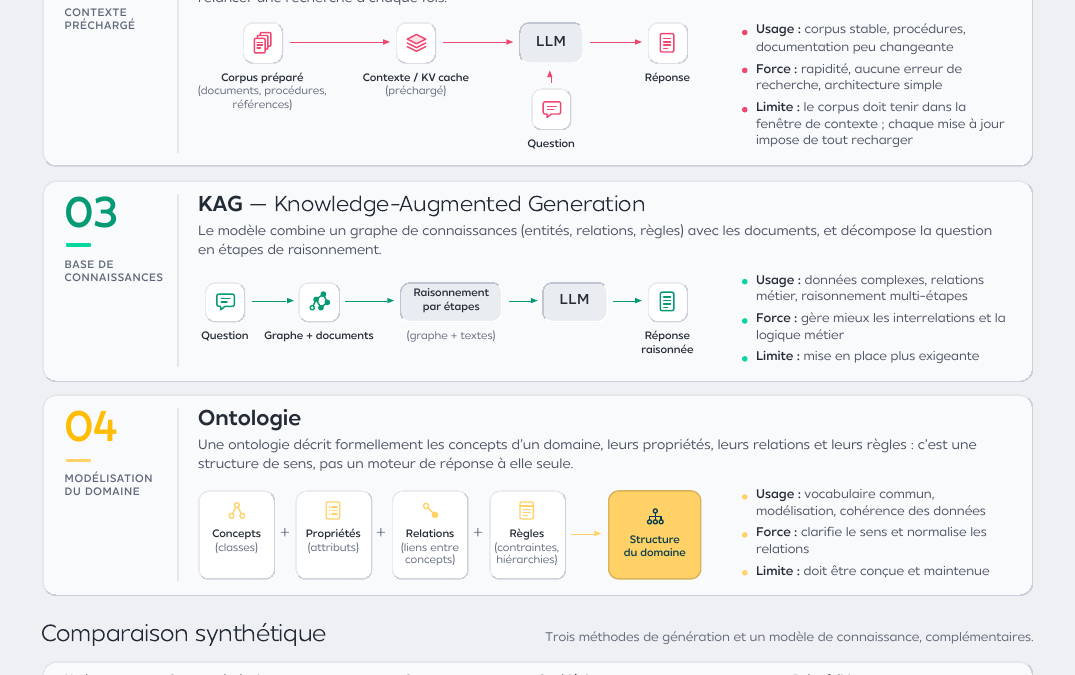
Ici, pas de documentaliste. Avant la première question, on fait lire à l’expert l’intégralité du dossier. Il l’a en tête pour toute la séance et répond directement.
C’est devenu possible parce que les modèles récents ont une fenêtre de contexte très large. C’est la quantité de texte qu’ils peuvent garder sous les yeux en même temps : de quelques centaines à quelques milliers de pages selon les modèles.
Le « cache » est ce qui rend l’approche rentable. Quand le modèle lit un texte, il calcule une représentation interne de chaque passage. Le CAG conserve ce travail pour ne pas le refaire à chaque question. Les fournisseurs d’API proposent d’ailleurs cette mise en cache sous le nom de prompt caching.
Points forts : aucune erreur de recherche n’est possible, puisqu’il n’y a pas de recherche. Une fois le chargement fait, les réponses sont rapides. Et l’architecture est bien plus simple qu’un RAG.
Points faibles :
- La base doit tenir dans la fenêtre de contexte, ce qui réserve le CAG aux corpus petits ou moyens.
- Elle doit être plutôt stable, car chaque modification impose de tout recharger.
- Sur des contextes très longs, les modèles exploitent moins bien les informations noyées au milieu.
KAG : l’expert qui raisonne sur une carte des liens
Knowledge-Augmented Generation, ou génération augmentée par la connaissance structurée
Cette fois, l’expert dispose des documents et d’une carte qui relie les notions entre elles. Par exemple : tel fournisseur → a signé tel contrat → est concerné par tel incident → traité par telle personne. Face à une question complexe, il la découpe en étapes, suit les liens de la carte et vérifie au fur et à mesure dans les textes.
Cette carte s’appelle un graphe de connaissances : des entités (personnes, produits, contrats…) reliées par des relations qui portent un nom. L’approche a été popularisée en 2024 par Ant Group, le groupe d’Alipay, qui a publié son framework en open source. Elle s’inscrit dans la lignée du GraphRAG de Microsoft, en y ajoutant un raisonnement logique guidé : la question est traduite en une suite d’opérations, dont certaines interrogent le graphe et d’autres les textes.
Points forts : le KAG excelle sur les questions « à plusieurs sauts », celles qui obligent à relier plusieurs faits. Il convient aux domaines où la rigueur prime : juridique, médical, finance, conformité. Ses réponses sont aussi plus traçables, puisqu’on peut suivre le chemin du raisonnement.
Point faible : construire et maintenir le graphe coûte cher. Il faut extraire les entités et les relations des documents (souvent avec l’aide d’un LLM), puis les nettoyer et les faire valider. C’est un vrai projet, pas un branchement en une après-midi.
Ontologie : le plan de classement et le dictionnaire officiel
L’ontologie est d’une autre nature que les trois précédents. Elle ne génère rien et ne va rien chercher. C’est un modèle formel d’un domaine, qui définit :
- les catégories de choses qui existent : Client, Fournisseur, Contrat, Incident ;
- leurs caractéristiques : un Contrat a une date d’échéance et un montant ;
- les relations autorisées : un Contrat est signé par un Fournisseur ;
- les règles et hiérarchies : un Fournisseur critique est un Fournisseur ; un Incident majeur déclenche une revue.
Ne la confondez pas avec une taxonomie, qui n’est qu’un arbre de classement du type « est une sorte de ». L’ontologie ajoute les relations transversales et les règles, et c’est ce qui permet à une machine de déduire des choses.
Pour les LLM, l’ontologie est la grammaire du graphe de connaissances. Le graphe contient les données, par exemple « le fournisseur Dupont a signé le contrat n° 42 ». L’ontologie est le schéma qui dit ce que ces données ont le droit d’être et ce qu’elles signifient. Sans elle, un graphe extrait automatiquement devient vite un fouillis : « Dupont », « Dupont SA » et « Ets Dupont » y figurent comme trois entités distinctes. Elle peut aussi améliorer un RAG classique, par exemple en enrichissant la question avec les termes liés ou en filtrant les documents par catégorie.
Comparatif
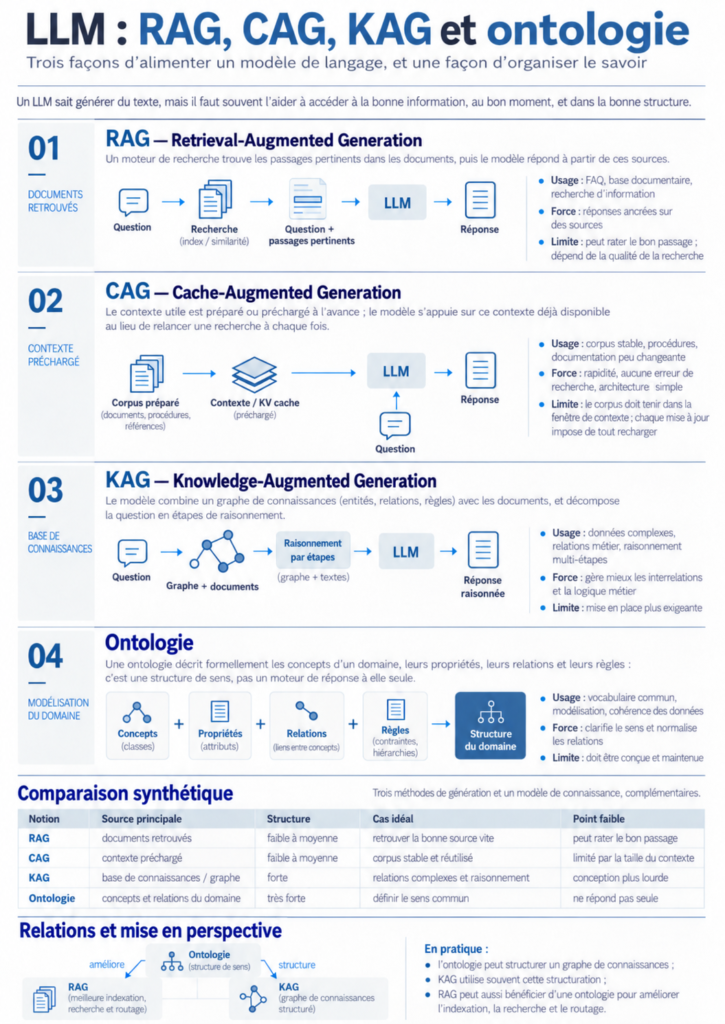
| RAG | CAG | KAG | Ontologie | |
|---|---|---|---|---|
| Nature | Méthode de génération | Méthode de génération | Méthode de génération | Modèle de connaissance |
| Le savoir arrive… | par recherche, à chaque question | chargé en entier, une fois | par le graphe + recherche | il ne fournit rien : il structure |
| Taille du corpus | Très grande | Petite à moyenne | Moyenne à grande | Sans objet |
| Idéal pour | Questions ponctuelles sur une grosse base | Petit corpus stable consulté en continu | Questions qui relient plusieurs faits | Donner un sens partagé et rigoureux aux données |
| Talon d’Achille | La recherche peut rater l’info | Limite de taille ; toute mise à jour oblige à tout recharger | Coût de construction du graphe | Long à concevoir, exige des experts métier |
| Effort de mise en place | Moyen | Faible | Élevé | Élevé |
Un même fonds documentaire, quatre usages
Prenons les procédures, contrats et comptes rendus d’une entreprise :
- RAG : « Quel est le délai de remboursement des notes de frais ? » On cherche une info précise dans une grosse base.
- CAG : un règlement intérieur de 60 pages, interrogé toute la journée par les équipes. Le corpus est court et stable.
- KAG : « Quels contrats de fournisseurs ayant eu un incident cette année arrivent à échéance avant juin ? » Il faut croiser fournisseurs, incidents et contrats.
- Ontologie : c’est elle qui permet à la machine de savoir ce qu’est un fournisseur, un incident ou un contrat, et comment ils se relient.
Ces approches ne s’excluent pas. Les systèmes sérieux sont souvent hybrides : un noyau stable en cache, le reste en RAG, et une ontologie pour structurer l’ensemble.
Attention aussi aux sigles, qui ne sont pas normalisés. Vous croiserez parfois « CAG » pour Context-Augmented Generation, ou « KAG » dans un sens générique. Vérifiez toujours la définition qu’emploie votre interlocuteur.